Code2Video — генерация учебных видео через код Manim и трёх агентов
📂 Исходный код на GitHubСистема, которая делает учебные видео из кода Manim. Агентный подход из трёх ролей: Planner раскладывает тему на сцены, Coder пишет исполняемый код, Critic смотрит на готовый ролик и правит вёрстку. С бенчмарком MMMC на 117 тем.
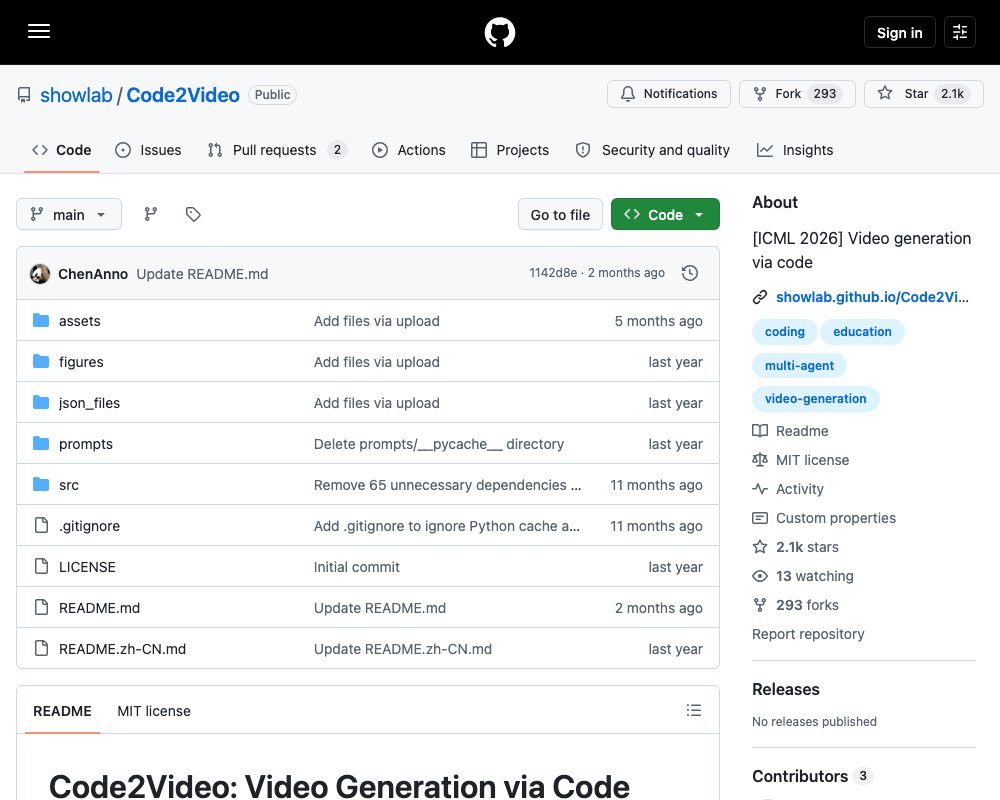
Code2Video делает учебные видео из кода. Обычные text-to-video модели рисуют картинку пиксель за пикселем. Здесь всё иначе: языковая модель пишет код анимации на Manim, и этот код запускается как обычная программа. Авторы из лаборатории Show Lab при Национальном университете Сингапура (Yanzhe Chen, Kevin Qinghong Lin, Mike Zheng Shou) называют это кодоцентричным подходом. Работа принята на ICML 2026, репозиторий открыт по лицензии MIT.
Три агента
Весь процесс ведут три роли. Промпт для каждой лежит в своём файле.
Planner готовит план. На первом шаге LLM пишет учебный план: тема, целевая аудитория, список разделов с примерами. На втором шаге план превращается в раскадровку. Для каждой сцены придумываются строки лекции и список анимаций к ним. Ограничения жёсткие: не больше 10 слов на одну строку лекции, в ключевых сценах — до 5 строк и 5 анимаций, в остальных — по три. Цвет фона зафиксирован на чёрном.
Coder пишет код. На вход он получает сцену и базовый класс, на выход отдаёт готовый класс Manim. Код приходится чинить. Рендер запускается отдельной командой. Если он падает, движок читает текст ошибки и просит модель починить только проблемное место.
Critic смотрит на результат. Его роль играет мультимодальная модель (MLLM). Она получает готовый ролик, картинку сетки и таблицу занятых ячеек. На выход — список правок вёрстки в JSON. Правки вносятся прямо в код, после чего ролик рендерится заново. По умолчанию таких кругов два.
Код вместо картинок
Главная инженерная идея — жёсткая сетка 6×6 на правой половине кадра. Слева лежат строки лекции, справа — анимация. У каждой ячейки есть имя: A1…F6. Позиционировать объекты разрешено только двумя вызовами:
self.place_at_grid(obj, 'B2', scale_factor=0.8)        # точка
self.place_in_area(obj, 'A1', 'C3', scale_factor=0.7)   # область
Прямые вызовы .to_edge() и .move_to() в промпте запрещены. Зачем это нужно: когда положение объекта записано в коде, его можно проверить. Critic не угадывает вёрстку, а читает таблицу занятых ячеек и говорит «строка N, элемент наезжает на подпись».
Базовый класс с сеткой лежит в файле prompts/base_class.py. Его подставляют в код каждой новой сцены.
Установка
Зависимости ставятся из папки src/:
cd src/
pip install -r requirements.txt
В requirements.txt зафиксирована Manim Community v0.19.0. Список зависимостей авторы пересобирали: из него убрали torch, transformers и все 16 пакетов NVIDIA CUDA. Проект считает, что видеокарта не нужна. По записи в истории репозитория это сократило время установки на 80–90%. Подробности по самой Manim — в официальном руководстве.
Ключи API вписываются в src/api_config.json. Там заготовки для Gemini, GPT-4.1, GPT-5, GPT-4o, o4-mini, Claude и IconFinder. Любой параметр можно переопределить переменной окружения с тем же именем в верхнем регистре.
Кому какой ключ нужен:
- LLM-ключ — Planner и Coder. Лучшее качество кода авторы получают на Claude-4-Opus.
- Ключ Gemini — Critic. Он смотрит на картинку и на видео.
- Ключ IconFinder — необязательный. Нужен, чтобы подтягивать иконки в ролик.
Два сценария запуска
Один ролик по одной теме:
sh run_agent_single.sh --knowledge_point "Linear transformations and matrices"Полный прогон по списку тем из json_files/long_video_topics_list.json:
sh run_agent.shОба скрипта — тонкая обёртка над src/agent.py. Параметры правятся прямо в них:
| Параметр | Что означает |
|---|---|
API |
какая модель пишет код: gpt-41, claude, gpt-5, gpt-4o, gpt-o4mini, Gemini |
FOLDER_PREFIX |
префикс папки с результатами |
MAX_CONCEPTS |
сколько тем взять, -1 — все |
PARALLEL_GROUP_NUM |
сколько групп тем считать параллельно |
Гиперпараметры тоже вынесены в скрипты: MAX_CODE_TOKEN_LENGTH=10000, MAX_FIX_BUG_TRIES=10, MAX_REGENERATE_TRIES=10, FEEDBACK_ROUNDS=2. Внутри одной темы рендер секций идёт через пул процессов. Темы разбиваются на пачки, и пачки считаются параллельно.
Полезная деталь: план, раскадровка и код каждой секции сохраняются в файлы (outline.json, storyboard.json, section_1.py). Если файлы уже есть, агент читает их и не тратит токены повторно. Правки Critic складываются в папку optimized_videos/.
Как чинятся ошибки Manim
Рендер каждой сцены — это команда manim -ql section_1.py Section1Scene с лимитом 180 секунд. При ошибке в игру вступает модуль src/scope_refine.py. Он классифицирует исключения (NameError, AttributeError, TypeError, ValueError, ImportError, SyntaxError, IndentationError), находит строку и колонку, вырезает кусок кода вокруг места поломки и просит модель сделать точечную правку. Если модель не смогла починить — цикл обрывается, а не крутится вечно.
Готовые куски склеиваются через ffmpeg в один файл.
Структура проекта
src/
│── agent.py              # весь пайплайн: план, раскадровка, код, рендер, склейка
│── run_agent.sh          # прогон по списку тем
│── run_agent_single.sh   # один ролик по одной теме
│── scope_refine.py       # разбор ошибок Manim и точечные правки
│── external_assets.py    # подбор и скачивание иконок
│── eval_TQ.py            # проверка, понял ли зритель тему
│── eval_AES.py           # оценка картинки и подачи
│── api_config.json       # ключи и модели
│── CASES/                # результаты, разложены по префиксу папки
assets/
├── icon/                 # кэш скачанных иконок
└── reference/            # картинки-референсы из уроков 3Blue1Brown
json_files/               # списки тем и привязка темы к референсу
prompts/                  # шаблоны промптов по стадиям
Папка assets/reference/ — это кадры из уроков 3Blue1Brown. Файл long_video_ref_mapping.json привязывает тему к картинке. Если привязка есть, Planner и Critic получают её как подсказку. Картинку в ролик не вставляют: её образ переосмысляют через объекты Manim.
Бенчмарк MMMC
Оценка идёт по трём осям.
Передача знаний — src/eval_TQ.py. По теме ролика задаются вопросы, и модели запрещают пользоваться памятью о предмете. Промпт в prompts/stage5_unlearning.py велит считать заблокированными определения, формулы и названия. Опираться можно только на текст вопроса и на сам ролик. Так проверяют, что знание пришло именно из видео.
Картинка и подача — src/eval_AES.py. Пять критериев по 20 баллов: расположение элементов, привлекательность, логика повествования, точность и глубина, единообразие стиля.
Стоимость — расход токенов и время генерации. Счётчик токенов ведётся прямо в agent.py. В конце прогона печатается среднее число токенов и минут на одну тему.
Сам набор — MMMC: 117 тем, собранных по мотивам 3Blue1Brown. Список лежит в json_files/long_video_topics_list.json. Сами ролики и метаданные выложены на Hugging Face.
Что важно понимать
Это исследовательский код, а не готовый продукт. Пайплайн требует платных API-ключей. Качество сильно зависит от модели: авторы прямо указывают, что лучший код Manim получается у Claude-4-Opus, а лучшая работа Critic — у Gemini.
Сравнительные ролики в readme сделаны на трёх темах: задача о ханойских башнях, языковые модели, ряд Фурье. Сравнение идёт против Veo3 и Wan2.2. Тем немного, но разница подхода видна сразу: у пиксельных моделей каждый кадр рисуется заново, у Code2Video — считается кодом. Длинные планы за счёт этого не рассыпаются.
Лицензия MIT, GPU не требуется, история на 100 коммитов. Статья — arXiv 2510.01174, сайт проекта — showlab.github.io/Code2Video.
Источник: https://github.com/showlab/Code2Video