Project Maya — GLM-5.3, DeepSeek и MiniMax на своих видеокартах
📂 Исходный код на GitHubДвижок инференса для запуска GLM-5.3 (744B), GLM-5.3-Flash (321B), DeepSeek-V4.1-Flash (748B) и MiniMax-M3.1-Flash (428B) на своих GPU: многоуровневое хранение экспертов в VRAM, RAM и на SSD, свои кванты XS–L, веб-панель и OpenAI- и Anthropic-совместимый API для кодинг-агентов.
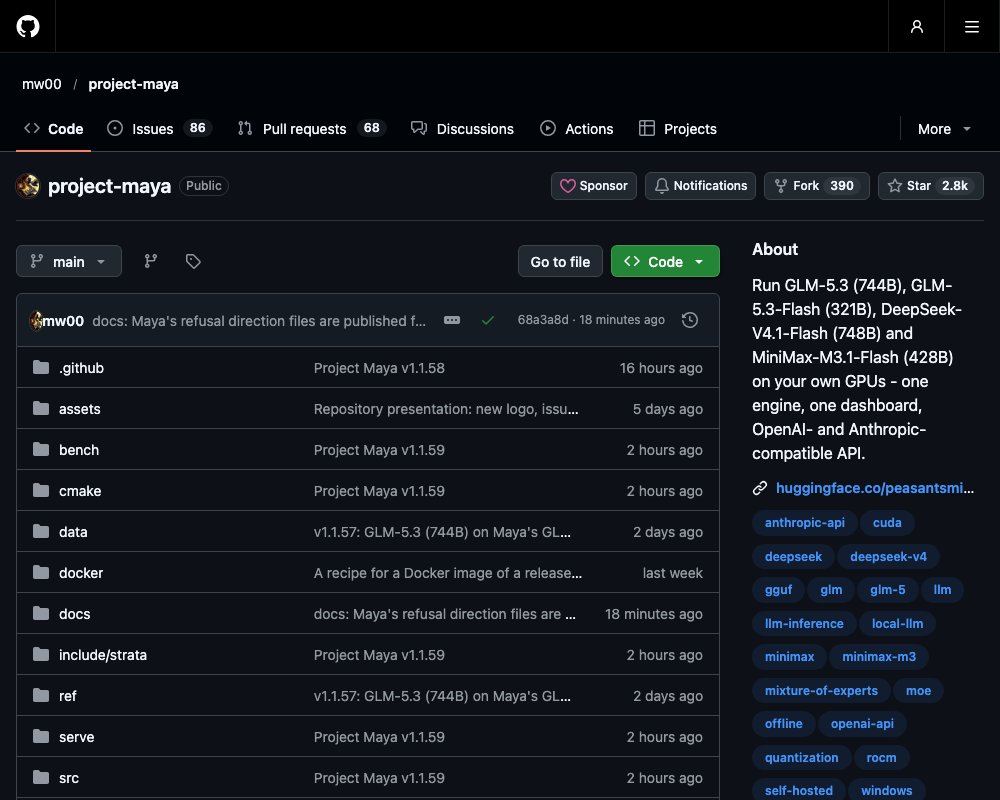
Модели на сотни миллиардов параметров обычно живут в дата-центрах. Project Maya — опенсорсный движок инференса (C++/CUDA, лицензия MIT, около 2,8 тыс. звёзд на GitHub), который запускает четыре такие модели на обычном домашнем железе: GLM-5.3 (744B), GLM-5.3-Flash (321B), DeepSeek-V4.1-Flash-1017 (748B) и MiniMax-M3.1-Flash (428B). Достаточно одной видеокарты NVIDIA — или до шестнадцати. Есть поддержка AMD и Windows. Под капотом — ggml/llama.cpp и формат EXL3, сделанный по образцу exllamav3. Каждая модель получает собственный движок, а не общий универсальный код. Всё работает на вашей машине: ни один запрос не уходит наружу.
Для каждой модели авторы готовят и свои кванты — сжатые версии весов, выложенные на Hugging Face.
Как это устроено
Все четыре модели построены на архитектуре MoE (Mixture of Experts): внутри модели много «экспертов» — отдельных блоков нейросети, — но для каждого токена срабатывают лишь несколько из них. Отсюда парадокс этих моделей: весят сотни гигабайт, а за один шаг задействуют только малую часть параметров. Проблема одна — куда положить все эти сотни гигабайт.
Ответ Maya — многоуровневое хранение. Эксперты, которые чаще всего встречаются в вашем диалоге, держатся в видеопамяти. Следующий уровень — в обычной RAM. Остальное лежит на NVMe SSD и подгружается по мере необходимости — прямо во время разговора, незаметно для вас. Движок замеряет ваши GPU, процессор, память и SSD и сам подстраивается под них: команда --calibrate за 10–15 минут подбирает настройки под конкретное железо. Один нюанс: пока Maya работает, она занимает почти всю свободную RAM (оставляет около 6 ГБ), так что другим программам памяти почти не остаётся.
Кванты Maya
Каждый квант назван по модели и уровню — XS, S, S24, M или L. Уровень определяет, сколько бит остаётся у весов каждого эксперта: меньше бит — меньше размер и быстрее работа, но чуть ниже качество. Установщик сам предлагает подходящий вариант, а можно выбрать и вручную: ./setup.sh --model glm-maya-s.
Качество квантов измеряют против исходных моделей. Кванты GLM-5.3-Flash сохраняют 97,7–99,2% точности FP8-версии на zero-shot задачах (Maya-L — 99,2%). Квант DeepSeek V4.1 · Maya-S выбирает тот же следующий токен, что и оригинал, в 92,6% случаев, MiniMax M3.1 · Maya-S — в 87,6%.
| Модель | Квант по умолчанию | Размер | Кому подходит |
|---|---|---|---|
| GLM-5.3-Flash — 321B, MIT | Maya-S (glm-maya-s) |
96,5 ГБ | небольшой пул памяти (RAM + VRAM) |
| GLM-5.3 — 744B, только текст | Maya-XS (glm-5.3-maya-xs) |
170 ГБ | целиком помещается в пул 192 ГБ |
| DeepSeek-V4.1-Flash-1017 — 748B, MIT | Maya-S (deepseek-maya-s) |
340 ГБ | любой объём памяти: не поместившееся читается с SSD |
| MiniMax-M3.1-Flash — 428B | Maya-XS (minimax-maya-xs) |
93 ГБ | целиком помещается в память ПК на 128 ГБ |
Для GLM-5.3-Flash есть и более крупные уровни — вплоть до Maya-L на 156,3 ГБ, ближайшего к оригиналу, и экспериментальный Maya-M-Derisked с правкой весов от Blackfrost_AI, уменьшающей число безосновательных отказов. Три модели из четырёх держат контекст до 1 млн токенов, а картинки читают все, кроме текстовой GLM-5.3.
Как быстро оно работает
Скорость измеряют сами пользователи на реальных машинах — команда --bench собирает отчёт, который публикуют в issues проекта. Несколько цифр для GLM-5.3-Flash:
| Машина | Скорость генерации |
|---|---|
| 2× RTX 5090 + RTX 4090 | 148,6 токенов/с |
| 2× H100 80 ГБ | 122,4 токенов/с |
| 4× RTX 4090 | 118 токенов/с |
| RTX PRO 6000 (96 ГБ) | 81 токен/с |
| Одна RTX 5090 | 30+ токенов/с |
| NVIDIA DGX Spark | 16,5 токенов/с |
DeepSeek-V4.1-Flash на восьми RTX 5090 выдает 184 токена/с. Для ориентира: токен — это примерно три четверти слова. Скорость почти не падает по мере роста диалога. Медленнее всего первые ответы после запуска, пока кэши заполняются.
Подключаем кодинг-агентов
Для Maya важен сценарий «локальная модель вместо облачного API», поэтому совместимость с агентами здесь на первом месте:
- OpenAI-совместимый API на
http://127.0.0.1:8080/v1и Anthropic-совместимый наhttp://127.0.0.1:8080/v1/messages. Для Claude Code достаточноANTHROPIC_BASE_URL=http://127.0.0.1:8080. - Вызов инструментов стримится — агент видит вызовы по мере генерации, а не после неё. Если запрос попросит (
"return_progress": true), движок будет сообщать, сколько длинного промпта уже прочитано. - Защита от зацикливания включена по умолчанию: если агент повторяет один и тот же вызов инструмента с тем же результатом, движок уводит его в сторону.
- До 8 параллельных запросов (GLM-5.3-Flash, DeepSeek, MiniMax) — для агентов с несколькими сессиями или несколькими людьми за одним ПК.
- Responses API на
/v1/responses: диалоги с текстом и картинками, стриминг, вызовы функций, вывод по JSON-схеме, фоновые задачи с отменой и повтором. - API управления моделями (
/api/tags,/api/ps,/api/chat,/api/pullи другие): запрос к незагруженной модели сам переключает движок на неё.
Веб-панель
После запуска всё управляется из браузера на http://127.0.0.1:8080:
- Чат — история хранится в браузере: поиск, закрепления, папки, инструкции для каждого чата, уровни размышления, правка и регенерация ответов.
- Monitor — живая сводка по модели и железу, вплоть до того, чем занята память каждой видеокарты.
- Страница Models — каталог всех моделей с размерами: скачать с прогресс-баром, загрузить, выгрузить или удалить — без командной строки.
- Turbo — одна кнопка выставляет самые быстрые настройки модели (жадный сэмплинг, без размышлений, пропуск экспертов, быстрый драфтинг). Качество при этом несколько падает. Повторное нажатие возвращает ваши настройки.
- Файлы и картинки — в чат можно приложить любой файл: текст и код идут как есть, PDF — своим текстом, Word, Excel, PowerPoint, OpenDocument, EPUB и RTF — тоже своим текстом. Все модели читают картинки, некоторые — видео.
- MCP-инструменты — серверы перечисляются в конфиге (
"mcp_servers"; блокmcpServersиз Claude Desktop подходит как есть), и модель в веб-чате может вызывать их инструменты. - Счётчик экономии — в боковой панели показывается, сколько стоили бы те же токены у «родного» API модели (DeepSeek, Z.ai или MiniMax), с учётом кэшированных цен.
Что нужно и как установить
| Компонент | Требования |
|---|---|
| GPU | NVIDIA с compute capability 7.0+ (V100, RTX 20 и новее) — одна или до 16; AMD: RX 7900 XT/XTX, Radeon AI PRO R9700, Strix/Gorgon Halo |
| RAM | минимум 32 ГБ; больше — больше экспертов рядом и выше скорость |
| Диск | быстрый NVMe SSD: от ~75 ГБ под GLM-5.3-Flash · Maya-XS до ~350 ГБ под DeepSeek · Maya-S; HDD не подойдёт |
| Система | Linux x86-64 + CUDA 12.x или Windows 10/11 (WSL2 не поддерживается); AMD — ROCm 7; Apple Silicon — экспериментально, только GLM-5.3-Flash |
Установка — две команды:
git clone https://github.com/mw00/project-maya.git && cd project-maya
./setup.sh
Установщик спросит, какую модель поставить, покажет предстоящее скачивание, один раз соберёт движок (20–40 минут плюс загрузка модели) и запустит её. Дальше открываете http://127.0.0.1:8080. В Windows вместо ./setup.sh — START-MAYA.bat. Ничего не ставится в систему, а установщик проверяет все требования и печатает точную команду для недостающего.
Если что-то пошло не так
Универсальный ответ — ./maya.sh --report: команда собирает железо, настройки и замеры скорости в файл maya-report.txt, который прикладывают к issue на GitHub. Типовые случаи: SSD занят всё время — не хватает RAM под экспертов (закройте программы или добавьте памяти); в Windows ответы резко замедлились — видеокарта переполнена, освободите место через --vram-reserve-mib; загрузка оборвалась — просто запустите ./maya.sh снова, она продолжит с места остановки.
Project Maya — бесплатный проект с лицензией MIT, построенный на ggml/llama.cpp, exllamav3 и beellama.cpp. Подробная документация — в docs/README.md, разбор моделей и их настроек — в docs/MODELS.md, подбор памяти под каждую модель — в docs/MEMORY.md.
Источник: https://github.com/mw00/project-maya