llama-modchip — запуск 284B MoE-моделей на CPU без GPU
📂 Исходный код на GitHubЗапуск 284B DeepSeek-V4-Flash и 30B MoE-моделей на чистом CPU: векторное квантование ниже 4 бит (LUT-VQ3-64, Fractal-64), спекулятивное декодирование Stockfish-PVS, мгновенный прогрев Claude Code, поддержка Zen 4/5, Apple Silicon, Windows-гибридов и ARM64.
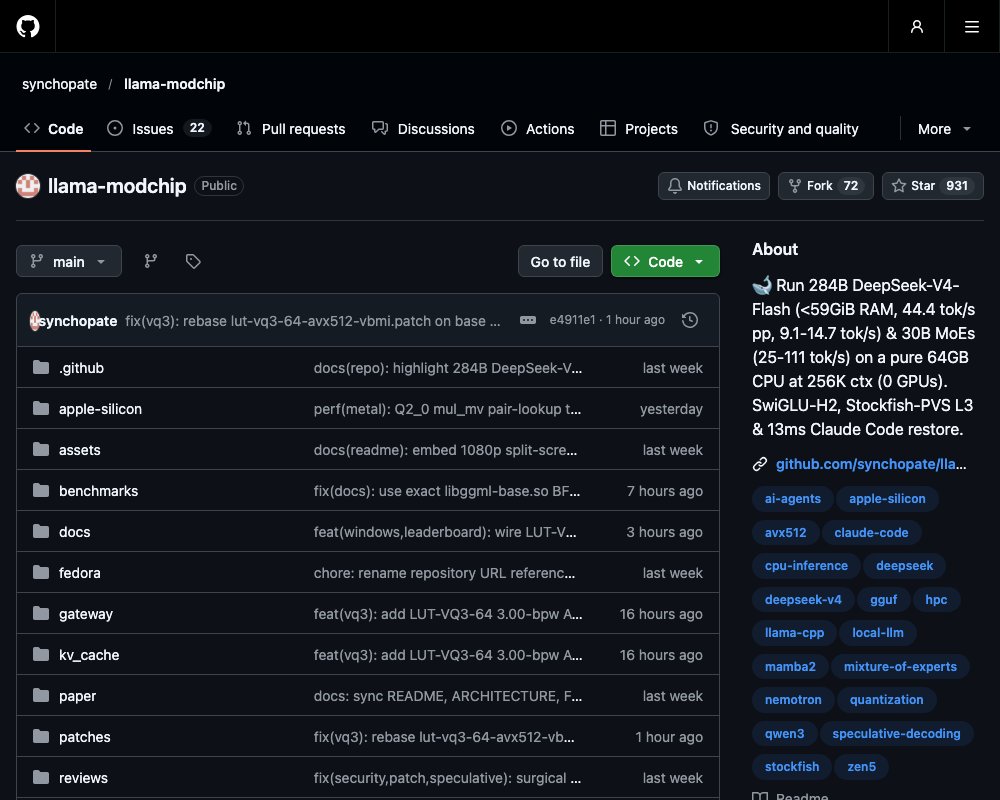
llama-modchip — это запатченный движок на базе llama.cpp с CLI-обвязкой, который запускает большие MoE-модели на обычном процессоре, без GPU. Главный результат проекта: DeepSeek-V4-Flash на 284 млрд параметров (13.17 млрд активных) ужимается до 56 ГиБ и целиком помещается в машину с 64 ГБ памяти. Скорость — 9–10 токенов/с на генерации и до 44 токенов/с на префилле. Модель поменьше, Nemotron-3.5-30B-A3B, влезает в 16 ГБ ОЗУ и выдаёт 24–60 токенов/с. Лицензия — Apache 2.0.
Проблема: барьер четырёх бит
Чтобы крупная модель поместилась в обычную память, её веса сжимают — квантуют. До появления llama-modchip выбор стоял между двумя плохими вариантами.
Первый — стандартные 4.5-битные скалярные форматы Q4_0 и Q4_K_M. Качество они держат, но трафик памяти у них высокий, а на CPU всё упирается в пропускную способность DRAM.
Второй — 2–3-битные форматы Q2_K и Q3_K. Места они занимают меньше, но распаковываются медленно, побитовыми сдвигами, и заметно деградируют на JSON-схемах для вызова инструментов.
Версия v2.5.0 убирает этот компромисс двумя собственными форматами.
Два формата: LUT-VQ3-64 и Fractal-64
LUT-VQ3-64 (тип GGML_TYPE_VQ3_0) — векторный квантователь с плотностью 3.00 бита на вес, 24 байта на 64 веса. Он кодирует не отдельные веса, а их тройки: 128 центроидов трёхмерного квантователя Ллойда—Макса размещаются не по кубической сетке, а прямо на сферической оболочке, где реально лежат веса MoE-слоёв. Распределение у этих весов с тяжёлыми хвостами, поэтому кубическая сетка расходует почти половину объёма впустую. Весь кодбук занимает 384 байта и постоянно хранится в шести регистрах ZMM. Распаковка стоит один такт: инструкция AVX-512 VPERMI2B выдаёт 64 центроида без обращений в кэш L1/L2.
Fractal-64 (тип GGML_TYPE_Q2_0) — формат на 3.75 бита на вес, 30 байт на 64 веса. Он тоже распаковывается за один такт, инструкцией VPSHUFB.
На реальных BF16-весах MoE-слоёв Fractal-64 даёт SQNR 17.75 дБ против 16.30 дБ у стандартного Q3_K, а LUT-VQ3-64 — 13.57 дБ против 10.15 дБ у Q2_K. Косинусная близость к эталону — 99.15% и 97.78% соответственно.
Гибрид с учётом роли тензора
Второй приём — сжимать разные тензоры по-разному. Расширяющие проекции FFN (ffn_up_exps, ffn_gate_shexp) кодируются в LUT-VQ3-64 с плотностью 3.00 бита на вес. Выходные проекции остаточного потока (ffn_down_exps, attn_output_b, attn_kv) остаются во Fractal-64 с плотностью 3.75 бита. Какой тензор в какой формат переводить, решают сборочные скрипты: build_nemotron_vq3.py и build_dsv4_vq3.py.
Такой перенос снижает трафик DRAM на 20–33% против Q4_0. При этом сквозной тест качества даёт 100 баллов из 100 — полный паритет с BF16 и Q4_0. Тест из eval_quality_and_tools.py проверяет три набора задач: вызов инструментов по JSON-схеме (30 баллов), генерацию кода с юнит-тестами (30 баллов) и поиск «иголки» в длинном контексте вместе с математикой (20 баллов).
Цифры
| Модель | Файл GGUF | RAM (VmRSS) | Скорость на CPU |
|---|---|---|---|
| DeepSeek-V4-Flash 284B, VQ3-гибрид | 56.07 ГиБ | 58.3 ГиБ | декод 9.05 ток/с, префилл 41.1 ток/с, агентные всплески 19.4–25.3 ток/с |
| Nemotron-3.5-30B-A3B, VQ3-гибрид | 13.08 ГиБ | 16.0 ГиБ | 24.2 ток/с E2E, до 60.4 ток/с |
| Nemotron-3.5-30B-A3B, Fractal-64 | 14.35 ГиБ | 15.4 ГиБ | 25.0 ток/с, до 60.4 ток/с |
64-ядерный Threadripper с 8-канальной DDR5 разгоняет 30B-модель до 111.6 ток/с.
Спекулятивное декодирование и прогрев Claude Code
Для агентных нагрузок в проекте собрана связка ускорителей:
- Stockfish-PVS v2 — спекулятивный драфтер с Zobrist-таблицей на 1.64 МБ в кэше L3. На VQ3-версии Nemotron он принимает 70.19% черновых токенов и поднимает сквозную скорость до 48.39 ток/с, с пиком 60.40 ток/с.
- RouteCrack — техника из того же стека спекулятивного декодирования, детали описаны в ROUTECRACK_TECHNIQUES.md.
- Мгновенный прогрев Claude Code — полный префикс системного промпта с 40 инструментами (2776 токенов) восстанавливается из /dev/shm за 10.4 мс. Первый токен тёплого хода приходит через 0.16 с. Команда
./modchip claudeзапускает Claude Code CLI на локальном движке с контекстом до 256K.
Установка и повседневные команды
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
Важный нюанс: форматы Fractal-64 и LUT-VQ3-64 используют нестандартные типы тензоров (GGML_TYPE_Q2_0 = 40 и GGML_TYPE_VQ3_0 = 43). Стоковые сборки llama.cpp, Ollama и LM Studio такие GGUF не откроют и упадут с ошибкой unknown tensor type 40/43. Нужен либо ./modchip, либо предсобранный статический бинарник llama-server-modchip-linux-x86_64 — он лежит в релизе v2.5.0 и в репозиториях Hugging Face рядом с весами.
Готовую модель вместе с бинарником можно скачать одной командой:
hf download Synchopate/NVIDIA-Nemotron-3.5-30B-A3B-VQ3-64-CPU-GGUF \
  llama-server-modchip-linux-x86_64 NVIDIA-Nemotron-3.5-30B-A3B-VQ3-64.gguf --local-dir .
chmod +x llama-server-modchip-linux-x86_64
./llama-server-modchip-linux-x86_64 -m NVIDIA-Nemotron-3.5-30B-A3B-VQ3-64.gguf -c 262144 -t 16 --port 8080
Основные команды обвязки:
| Команда | Что делает |
|---|---|
./modchip chat |
терминальный чат с телеметрией: скорость, TTFT, принятие PVS |
./modchip web |
веб-чат и живая телеметрия на порту 8787 |
./modchip bench |
30-секундный тест скорости с карточкой для лидерборда |
./modchip claude |
запуск Claude Code CLI на локальном движке |
./modchip eval |
воспроизводимый 100-балльный тест качества |
./modchip quantize |
конвертация BF16/Q4_0 GGUF во Fractal-64 или Fractal-MXFP4 |
Готовность железа проверяется скриптом check_cpu_readiness.py — модель скачивать не нужно.
Поддерживаемое железо
- AMD Zen 5 (Ryzen 9 9955HX, Ryzen 9 9950X, EPYC 9005) — полный AVX-512, тайлинг L1D, изоляция L3-кэша.
- Threadripper PRO (Zen 4) — восемь CCD и 8-канальная DDR5, до 111.6 ток/с на 30B-модели.
- Apple Silicon M1–M5 — Metal-шейдеры для Fractal-64 и NEON/AMX-ядра. На M5 Max 284B DeepSeek декодирует на 27 ток/с, реальная генерация в llama-server — 20.7–23.6 ток/с.
- Windows 10/11 — гибрид CPU+GPU: внимание остаётся на видеокарте, «холодные» MoE-эксперты живут в RAM, bat-скрипт сам считает разрез
--n-cpu-moe. - ARM64 в облаке — Graviton3 с SVE-256, 44.97 ток/с на декодировании.
Свои результаты можно отправить в общий лидерборд проекта через GitHub-issue: там уже есть машины от Threadripper и M4 Max до Xeon E5-2670 2012 года.
Документация
- ARCHITECTURE.md — математическое описание форматов и оптимизаций.
- NEMOTRON_OPTIMIZATIONS.md и DEEPSEEK_V4_OPTIMIZATIONS.md — разбор каждой модели: профилирование операторов, SVD, ablations.
- HARDWARE_OPTIMIZATIONS.md — настройка под конкретные процессоры.
- FAQ.md — инженерные вопросы.